 Москва, ул. Пришвина, д.8, корп.2


В начале 1950-х годов инженеры IBM разрабатывали систему хранения информации на магнитной ленте и столкнулись с неожиданной проблемой. Компьютеры уже могли обрабатывать данные с высокой для своего времени скоростью, а вот массивные катушки не успевали за ними. Лента должна была быстро разгоняться и останавливаться, но при резких изменениях скорости она натягивалась и могла порваться.
И что помогло решить задачу? Обычный бытовой пылесос. А чуть позже инженерам понадобились ещё и детские непромокаемые штанишки. Причём это не компьютерная легенда, а вполне реальная история, сохранившаяся в архиве IBM.
С тех пор технологии хранения изменились до неузнаваемости. Сегодня компании могут размещать резервные копии в другом городе, поддерживать актуальные данные сразу на нескольких площадках и восстанавливать сервисы на заранее подготовленных серверах.
Последние недели мы в ESTT много рассказывали о георезервировании, о том, как подготовиться к недоступности основного дата-центра и почему резервная копия сама по себе не гарантирует быстрого восстановления. Сейчас эти вопросы приобретают дополнительное значение: свободных мощностей в московских ЦОДах становится меньше, строительство новых площадок требует времени, а стоимость размещения оборудования растёт.
Но начиналась история резервирования совсем не с дата-центров и облачных технологий. Сначала инженерам пришлось научиться хотя бы надёжно записывать и считывать информацию.
Как пылесос помог инженерам IBM
В начале 1950-х основным средством хранения и переноса информации в вычислительных системах оставались перфокарты. Для больших массивов данных требовались тысячи карточек, специальное оборудование и немало времени на обработку.
Магнитная лента выглядела гораздо перспективнее. Технология записи уже использовалась в звукозаписи, и инженеры рассчитывали приспособить её для компьютеров.
Однако оказалось, что быстро перемещать тонкую ленту между двумя тяжёлыми катушками не так просто. При резком торможении катушки продолжали вращаться по инерции, что создавало риск повреждения носителя.
Над проблемой работала команда инженера IBM Джеймса Вайденхаммера. После нескольких неудачных экспериментов они решили использовать воздушный поток для управления свободной петлёй ленты. В качестве источника разрежения взяли обычный пылесос.
Идея сработала. Лента втягивалась в специальную камеру, где образовывалась петля, компенсирующая разницу в скорости движения катушек и участка ленты у считывающей головки. Благодаря этому накопитель мог значительно быстрее начинать и останавливать чтение.
Для одного из элементов экспериментальной конструкции потребовался тонкий гибкий материал. Подходящего в лаборатории не нашлось, и Вайденхаммер отправил молодого инженера Джека Сили в аптеку за детскими непромокаемыми штанишками. Их материал использовали для изготовления клапана, необходимого для поддержания разрежения.
В 1952 году IBM анонсировала накопитель Model 726, а в 1953 году он начал использоваться вместе с компьютером IBM 701. Устройство позволяло хранить до двух миллионов десятичных цифр на одной катушке. Аренда такого накопителя обходилась в 850 долларов в месяц.
Вакуумные камеры оказались удачным инженерным решением и применялись в ленточных накопителях ещё несколько десятилетий. А вращающиеся катушки постепенно стали одним из самых узнаваемых символов компьютерной эпохи.
Первый жёсткий диск весил больше тонны
Следующий важный шаг был сделан в 1956 году. IBM представила систему 305 RAMAC с первым коммерческим жёстким диском.
Накопитель состоял из 50 металлических пластин диаметром 24 дюйма. Вся установка со вспомогательным оборудованием весила больше тонны и позволяла хранить примерно 3,75 МБ данных.
Сегодня подобный объём может занимать одна фотография со смартфона, а тогда для его хранения требовалось оборудование размером с большой шкаф.
Главным достижением RAMAC стала даже не ёмкость, а возможность относительно быстро получать доступ к нужным данным. В отличие от магнитной ленты, которую приходилось перематывать, диск позволял обращаться непосредственно к определённому участку информации.
По мере развития компьютеров диски всё активнее использовались для повседневной работы, а магнитные ленты постепенно заняли важное место в архивировании и резервном копировании.
И здесь возникла проблема, которая позже повлияла на развитие всей индустрии дата-центров.
Почему резервная копия перестала быть гарантией спокойствия
В 1960-х и 1970-х годах резервное копирование часто выглядело довольно просто. Данные записывали на магнитные ленты, катушки маркировали и помещали в специальные хранилища. Некоторые организации отправляли копии в другое здание, чтобы при аварии основного вычислительного центра информация не пострадала.
Сохранить данные таким образом было вполне возможно. Гораздо сложнее оказалось восстановить работу компании.
Представим крупную организацию конца 1970-х годов. Её вычислительный центр выходит из строя, но резервные ленты остались целыми. Чтобы снова запустить информационные системы, необходимо найти совместимое оборудование, подготовить программное обеспечение и восстановить данные. На это могли уйти дни, а иногда и значительно больше времени.
Для банков, транспортных компаний и предприятий, работа которых уже серьёзно зависела от компьютеров, подобные простои становились слишком дорогими.
Так начал формироваться рынок резервных вычислительных площадок. В конце 1970-х появились коммерческие компании, предлагавшие клиентам доступ к запасным вычислительным мощностям на случай серьёзного сбоя. Позднее за такими площадками закрепилось название hot site.
Вместо того чтобы хранить только копии информации, организация могла заранее договориться о доступе к оборудованию, на котором при необходимости восстанавливались её системы.
Резервирование постепенно переставало быть исключительно задачей хранения данных. Теперь нужно было позаботиться и о том, где эти данные смогут снова использоваться.
Когда копии научились передавать между площадками
Следующий этап был связан с развитием компьютерных сетей и систем хранения.
Раньше резервную ленту нередко приходилось физически перевозить в другое здание или город. Между созданием копии и её доставкой проходило время, а все последующие изменения данных оставались только на основной площадке.
В 1990-х получили распространение технологии удалённого копирования. Они позволяли передавать данные между вычислительными центрами по каналам связи, постепенно уменьшая зависимость от физической перевозки носителей.
Одновременно развивалась репликация, при которой изменения в основной системе передаются на резервную. В зависимости от выбранной технологии такая передача может происходить практически одновременно с записью или с определённой задержкой.
Это заметно расширило возможности резервирования. Компании получили инструменты для поддержки актуальных копий данных на удалённых площадках, а развитие виртуализации впоследствии упростило восстановление серверов и приложений.
При этом обычные резервные копии не потеряли своей актуальности. Если данные были случайно удалены или повреждены, ошибка могла распространиться и на реплику. Поэтому хранение предыдущих версий информации осталось необходимым дополнением к технологиям репликации.
Так постепенно сформировался современный подход, в котором используются разные способы защиты: резервные копии, репликация, запасные вычислительные мощности и заранее подготовленные сценарии восстановления.
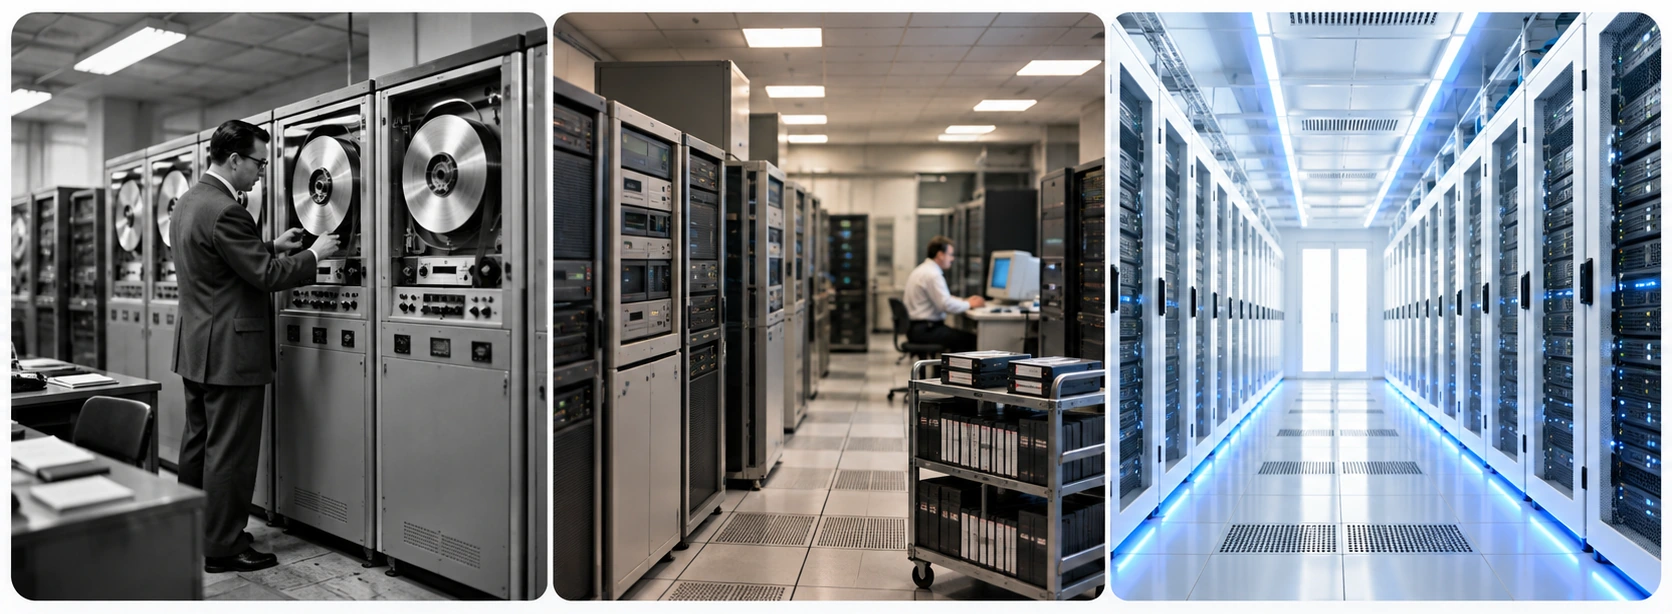
Магнитные ленты, кстати, никуда не исчезли
Может показаться, что с появлением жёстких дисков, SSD и облачных хранилищ магнитные ленты должны были окончательно уйти в музей. Но этого не произошло.
Например, современный накопитель IBM TS1170 поддерживает картриджи ёмкостью до 50 ТБ без сжатия. Для длительного хранения больших архивов магнитная лента до сих пор остаётся экономически привлекательной технологией.
Один из наиболее интересных примеров её применения можно найти в CERN, Европейской организации по ядерным исследованиям.
В декабре 2025 года CERN сообщил, что за время работы Большого адронного коллайдера в его систему хранения поступил один экзабайт экспериментальных данных. Это миллион терабайт информации, большая часть которой хранится именно на магнитных лентах.
Результаты экспериментов необходимо сохранять десятилетиями, поскольку новые методы анализа могут позволить учёным вернуться к старым данным и обнаружить то, что раньше оставалось незамеченным.
Получается довольно интересная история. Технология, над совершенствованием которой инженеры IBM работали с помощью пылесоса, спустя семь десятилетий продолжает использоваться в одном из крупнейших научных центров мира.
И это хороший пример того, что современные технологии не обязательно полностью заменяют старые. Чаще они дополняют друг друга, решая разные задачи.
А что происходит с резервированием сегодня?
За прошедшие десятилетия резервная инфраструктура стала значительно доступнее. Для создания резервной площадки больше не обязательно покупать второй комплект дорогостоящего оборудования и строить отдельное здание. Можно использовать существующий дата-центр, арендовать выделенные серверы или виртуальные ресурсы и подготовить необходимую инфраструктуру под конкретные задачи.
Однако в последние годы появилась другая проблема: сами вычислительные мощности и места для размещения оборудования становятся всё более востребованными.
По данным iKS-Consulting и 3data, во втором квартале 2026 года средняя стоимость аренды стандартной стойки мощностью 5 кВт в Москве достигла 170,8 тыс. рублей в месяц, увеличившись на 15,7% за год. Участники рынка связывают рост цен в том числе с дефицитом свободных мощностей и замедлением строительства новых дата-центров.
Показателен пример IXcellerate. В 2025 году оператор сообщил об открытии московского ЦОДа MOS3 на 2400 стойко-мест. Причём все стойки были зарезервированы заказчиками ещё на этапе строительства.
Это не означает, что в Москве совсем не осталось свободных площадок. Но хорошо показывает, насколько изменился рынок. Новые мощности могут находить клиентов задолго до официального запуска, а компаниям приходится учитывать доступность инфраструктуры при планировании своих проектов.
Для резервирования это особенно важно. Если основная площадка внезапно станет недоступна, рассчитывать на то, что необходимое оборудование и стойко-места удастся быстро найти именно в этот момент, довольно рискованно.
Поэтому резервную инфраструктуру разумнее готовить заранее, пока основная система продолжает нормально работать.
При этом речь не обязательно должна идти о полном дублировании существующего дата-центра. Во многих случаях достаточно определить, какие данные и сервисы действительно критичны, и подобрать резервные ресурсы именно под них.
Например, компания может продолжать использовать собственные физические серверы на основной площадке, а резервные копии хранить в другом ЦОДе. Следующим шагом может стать подготовка отдельных виртуальных машин или выделенного сервера, на которых при необходимости можно восстановить работу важных приложений.
Для одних компаний достаточно ежедневного резервного копирования. Другим требуется более частая передача данных и возможность восстановить критичные сервисы в течение короткого времени. Выбор зависит от того, сколько информации компания готова потерять при аварии и как долго может оставаться без своих систем.
Главное, чтобы резервирование было не просто пунктом в документации, а проверенной возможностью восстановить работу.
От катушки с лентой до резервного ЦОДа
Если оглянуться на историю вычислительной техники, становится заметно, как постепенно менялась сама задача защиты информации.
Сначала инженеры искали способы надёжно записывать и хранить данные. Затем появились резервные копии, которые можно было физически отделить от основного оборудования. Позднее компании начали готовить запасные вычислительные площадки, развивать удалённую репликацию и автоматизировать восстановление систем.
Сегодня для большинства таких задач не нужно создавать собственную инфраструктуру с нуля. Можно использовать ресурсы существующих операторов и постепенно развивать резервный контур по мере роста требований.
В ESTT для этого можно разместить оборудование в московском дата-центре, арендовать физические серверы или виртуальные ресурсы, организовать сетевые подключения и подготовить инфраструктуру для хранения резервных данных и восстановления сервисов.
Если вы рассматриваете резервную площадку, можно начать с определения необходимых ресурсов и обсуждения возможной конфигурации с нашими инженерами.
А история с пылесосом IBM напоминает, что за всеми современными системами хранения, репликации и резервирования стоят десятилетия инженерных экспериментов. Некоторые из них начинались с решений, которые сегодня выглядят весьма неожиданно.